Optymalne metody kompresji archiwów
Notatka opisuje kilka optymalnych algorytmów kompresji stosowanych do tworzenia archiwów. W szczególności pełniących rolę kopii zapasowej lub nośnika danych przekazywanych innym.
Aktualną wersję w formacie PDF możesz pobrać tu: [PDF]
Motywacja
Najczęściej stosowane algorytmy kompresji danych w systemach z rodziny UN*X takie jak bzip2 i gzip ze względu na swój wiek stały się nieefektywnym narzędziem archiwizacyjnym. Wprowadzenie na początku lat 2000 nowocześniejszych metod kompresji opartych o algorytm LZMA umożliwiło drastyczne (nawet do 70%) zmniejszenie przestrzeni dyskowej koniecznej do przechowywania tej samej ilości danych. Niesie to ze sobą możliwości obniżenia zarówno kosztów przechowywania danych, jak i obniżenia wagi szkodliwych substancji, które emitowane są do środowiska podczas ich transferu. Według uśrednionych szacunków pochodzących z badań[1] [2] przesłanie 1MB danych generuje około 10g CO2.
Proponowane metody kompresji
LZIP
Lzip jest algorytmem dostępnym na zasadach Powszechnej Licencji Wolnego Oprogramowania GNU (GPL). Został wdrożony do powszechnego użytku przez dystrybucje systemu GNU/Linux takie jak GNU Guix i Dragora; organizację IANA, która wykorzystuje go do dystrybucji bazy informacji o strefach czasowych oraz Parlament Europejski, który z jego wykorzystaniem publikuje zrzuty swojej bazy danych w formacie JSON.
Podstawowa implementacja lzip nie posiada obsługi wielu wątków
procesora, wydłużając tym samym czas kompresji i dekompresji
przetwarzanych danych. W repozytoriach wielu dystrybucji udostępniono
pakiet plzip, który pozwala na równoległą kompresję archiwów z
wykorzystaniem wielu wątków procesora.
Wśród narzędzi konsumenckich algorytm ten jest obsługiwany przez narzędzie kompresji środowiska graficznego GNOME, Midnight Commander oraz zmodyfikowaną wersję archiwizatora 7-zip dostępną również na platformę MS Windows.
Przykłady zastosowania
By skompresować dane za pomocą lzip stosujemy komendę:
tar cv katalog_z_danymi | lzip -c -f - > archiwum.tar.lz
Archiwum to możemy rozpakować za pomocą komendy:
tar xf archiwum.tar.lz
Stosując kompresję wielowątkową z plzip dobrze jest unikać mieszania
z jednowątkowym tar, dlatego też kompresję wykonamy za pomocą komend:
tar cv katalog_z_danymi > archiwum.tar
plzip -c -f archiwum.tar > archiwum.tar.lz
a dekompresję wykonując:
plzip -d archiwum.tar.lz
tar xf archiwum.tar
Zstandard
Jest to algorytm opracowany przez pracowników Facebooka i opublikowany
na zasadach licencji Otwartego Oprogramowania BSD. Wśród wdrażających
go organizacji znajdziemy dystrybucję systemu GNU/Linux
Archlinux. Jest on również rozważany jako domyślny format kompresji
archiwów *.deb dystrybucji GNU/Debian i Ubuntu.
W repozytoriach dystrybucyjnych obecny jest jako pakiet zstd.
Przykład zastosowania
W celu utworzenia archiwum z wykorzystaniem zstd wykonujemy komendę:
tar cv katalog_z_danymi | zstd -c -z -q - > archiwum.tar.zst
Skompresowane pakiety rozpakowujemy za pomocą:
tar -I zstd -xvf archiwum.tar.zst
Podobnie jak algorytm Lzip, obsługiwany jest przez narzędzie archiwizacyjne środowiska GNOME, zmodyfikowaną wersję 7-zip oraz bazy danych AWS Redshift i RocksDB.
7-zip
Narzędzie wprowadzone na początku lat 2000, które jako jedno z pierwszych stosowało algorytm LZMA. Jest ono powszechnie dostępne na platformach MS Windows (na zasadach licencji LGPL/BSD/unRAR), macos (od wersji 1.0 jest to oprogramowanie własnościowe) oraz GNU/Linux (LGPLv2). Stanowi to ogromną zaletę jeśli kompresujemy nasze dane, by przekazać je współpracownikom i podwykonawcom.
Przykład zastosowania
By uzyskać siłę kompresji archiwum porównywalną z zaprezentowanymi wcześniej algorytmami, kompresję z wykorzystaniem 7zip przeprowadzimy za pomocą komendy:
tar cv katalog_z_danymi | 7z a -t7z -m0=lzma -mx=9 -mfb=64 -md=32m -ms=on -si archiwum.tar.7zArchiwum dekompresujemy wywołując:
7z x archiwum.tar.7z
tar xf archiwum.tar
Porównanie skuteczności kompresji
Dla paczki logów osiągi wymienionych wcześniej komend prezentują się następująco:
473M    archiwum.tar
26M     archiwum.tar.gz
11M     archiwum.tar.lz
14M     archiwum.tar.zst
11M     archiwum.tar.7z
Dla zróżnicowanych plików użytkowników jednego z serwisów, zawierających dużo danych w postaci binarnej (pliki obrazów/PDF):
19G     files/
18G     files.tar
16G     files.tar.gz
12G     files.tar.lz
13G     files.tar.zst (najkrótszy czas kompresji)
11G     files.tar.7z
Kompresji do archiwum gzip dokonano z wykorzystaniem komendy:
tar cv katalog | gzip --best > archiwum.tar.gz
Pozostałe uwagi
Należy zauważyć, że ewentualne wdrożenie opisywanych algorytmów do kompresji logów odkładanych na serwerach może skutkować utratą kompatybilności z narzędziami takimi jak zcat, bzcat oraz fgrep, służącymi do szybkiego ich przeglądania i przeszukiwania z uwzględnieniem paczek po rotacji.
Bezpieczna Komunikacja dla zwykłych ludzi na BSides Warsaw 2018
Już siódmy raz miałem okazję wystąpić na SBSie. Tegoroczną prezentację poświęciłem lekkiemu przeglądowi powszechnie wykorzystywanych narzędzi do komunikacji w sieci (nie tylko real-time), bezpiecznym alternatywom i dobrym praktykom.
Zapis prezentacji:

BleachBit, bezpieczne usuwanie danych
Poniższy wpis przedstawia na razie najbardziej przydatną funkcję programu, która pozwoli na usunięcie plików w sposób niemożliwy do odzyskania. Z czasem będę go uzupełniał o opisy kolejnych funkcji.
Aktualną wersję poradnika w formacie PDF możesz pobrać tu: [PDF]
Opis programu
 BleachBit to program oferujący przede wszystkim możliwość wyczyszczenia systemów
operacyjnych (MS Windows/macOS/Linux) ze zbędnych plików pozostających na dysku podczas normalnego użytkowania komputera. Dodatkową, ważną funkcją programu jest bezpieczne usuwanie plików i katalogów w sposób, który zaciera po nich wszystkie ślady i czyni je niemożliwymi do odzyskania.
Witryna oprogramowania: https://www.bleachbit.org/
Proces instalacji w systemie Windows
By pobrać pakiet instalacyjny BleachBit należy odwiedzić witrynę programu i pobrać archiwum w formacie .exe (pierwsza opcja na liście). Przeprowadzając normalny proces instalacji należy upewnić się, czy w dostępnych komponentach programu pozostała zaznaczona opcja „integrate shred”. Po zakończeniu instalacji zostanie uruchomiony program BleachBit.
Dla pozostałych systemów operacyjnych proces instalacji jest również standardowy, w przypadku macOS pobieramy właściwy pakiet instalacyjny i postępujemy z nim jak z każdym innym nowym programem. W przypadku systemów
GNU/Linux dokonujemy instalacji z repozytoriów naszej dystrybucji.
Bezpieczne usuwanie katalogów z dysku
Po uruchomieniu programu BleachBit z menu Plik wybieramy opcję Potnij katalogi:
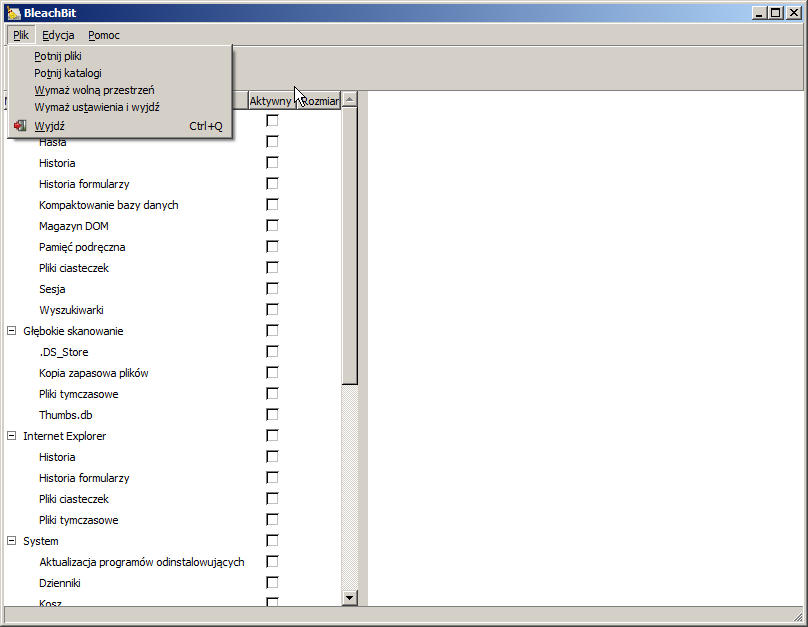
Wybór katalogów do usunięcia
Zostanie nam wyświetlone okno, w którym wskazujemy katalog z danymi do usunięcia:
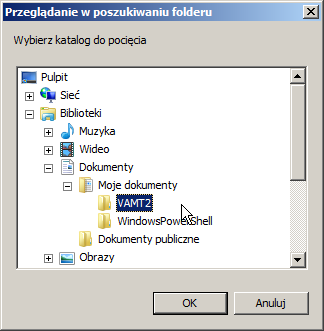
Potwierdzenie wyboru – decyzja, której nie możemy cofnąć
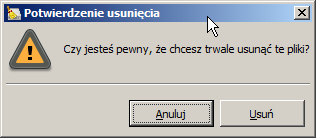
Przed rozpoczęciem usuwania zostaniemy poproszeni o potwierdzenie naszego wyboru. W tle wyświetli się lista katalogów i plików do usunięcia, która pozwoli nam na upewnienie się, że chcemy usunąć właściwe dane.
UWAGA: Po potwierdzeniu tej operacji usunięte dane stają się niemożliwe do odzyskania. Upewnij się, że ich usunięcie jest niezbędne, bądź posiadasz kopię zapasową.
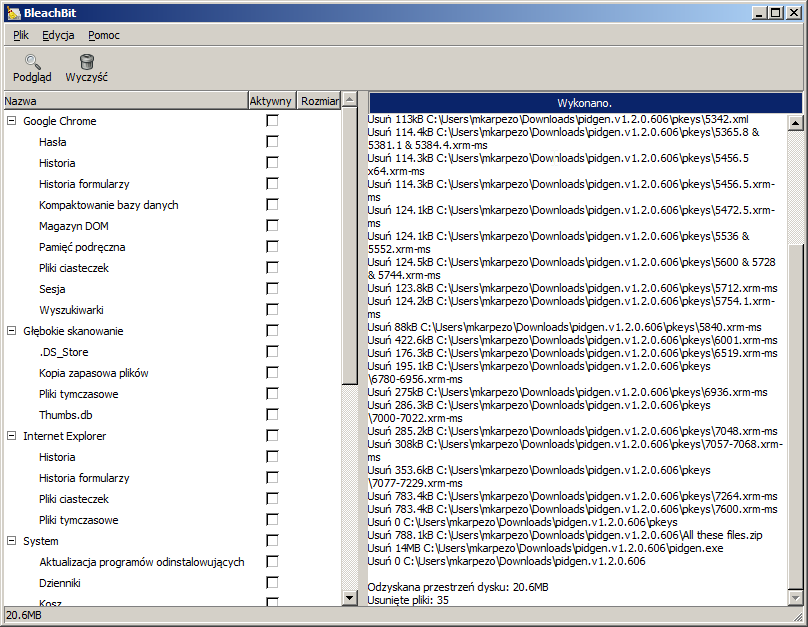
Proces usuwania i jego zakończenie
W trakcie usuwania BleachBit będzie nas informował o postępie usuwania danych. W zależności od ilości plików oraz struktury katalogów proces może potrwać od kilkunastu sekund do kilku godzin. Po jego wykonaniu na pasku postępu wyświetli się właściwy komunikat.
Samsung Galaxy S (GT-I9000) aktualizacja do KitKat
Poniżej przedstawione działania na pewno skasują wszelkie dane z Twojego telefonu. Mogą też spowodować, że nie będzie on działał i znajdzie się w stanie znanym jako brick.
Root i CWM Recovery
Dla powodzenia całego procesu nasz system powinien działać pod kontrolą systemu Android Gingerbread 2.3.5. Dodatkowo w trakcie należy dostosowywać wszelkie buildy w związku z tym polecam flashowanie takiego, do którego mamy komplet paczek. Propozycję można znaleźć pod adresem: https://archive.org/details/i9000_galaxysmtd.7z. Zawiera ona:
- sterowniki dla telefonów Samsung;
- właściwą wersję programu Odin, która działa z naszym tlefonem;
- kompletny obraz systemu, root, oraz jądro systemu z CWM recovery;
- ostatnie wydanie cyanogenmoda 11 dla telefonu galaxysmtd;
- działające z nim google apps.
Dodatkowa uwaga: dobrze jest wykonywać działania na systemie Windows, który gotowi jesteśmy potem reinstalować, bo może w wyniku tych działań zostać zawirusowany. Maszyna wirtualna nas nie urządza.
Pierwszym krokiem jest instalacja sterowników Samsung dla naszego telefonu i ponowne uruchomienie systemu. Kolejny to uruchomienie Odina w wersji 1.83, która jako ostatnia właściwie obsługuje model I9000.
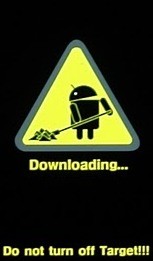
Teraz zajmujemy się telefonem i uruchamiamy go w trybie Download trzymając jednocześnie przyciski VOL DOWN + POWER + HOME. Trzymamy je do momentu, w którym na ekranie pojawi się żółta grafika i napisy. Po podłączeniu telefonu Odin powinien zareagować i wyświetlić komunikat zawierający Added.
Ubuntu i Bash, od czego zacząć?
Piszę z zawodową sprawą, pytaniem do eksperta Linuxa. Kiedyś przez krótki czas korzystałem z Minta, ale postanowiłem się poznać go na porządnie korzystając z najpowszechniejszej wersji – Ubuntu.
Czy możesz mi polecić co powinienem poznać by poruszać się po nim sprawnie oraz gdzie/jak mogę tego dokonać (szkolenia, tutoriale)?
Dodatkowo możesz mi wytłumaczyć popularność Basha, dlaczego jest tak ważny? Jego też bym chciał poznać więc wszelkie wskazówki do nauki mile widziane.
Ubuntu będzie całkowicie w porządku do nauki systemów GNU/Linux. Obecnie obok Centos zdaje się być standardem zarówno na desktopach jak i na serwerach. Włącznie z tym, że bez składania specjalnego zamówienia, mój służbowy komputer przyszedł właśnie z Ubuntu na pokładzie. Obecnie korzystam z Ubuntu Studio, które ułatwia mi konfigurację i pracę z multimediami, którą dość często wykonuję.
W sprawie porządnej nauki Ubuntu gorąco polecam Ci książkę „Ubuntu. Oficjalny podręcznik. Wydanie VIII”. Nie jest droga, a zawiera całkiem fajnie przedstawione rozmaite aspekty systemu nie tylko dla początkujących, ale również dla zaawansowanych. Poza książką najprostszą metodą uczenia się systemu jest wyszukiwanie rozwiązań swoich problemów w sieci i wprowadzanie ich w życie oraz samodzielne kombinowanie bez obawy o zepsucie systemu. Zakładając, że będziesz robił kopię zapasową ważnych dla siebie danych ponowna instalacja systemu zajmie zaledwie kilkadziesiąt minut.
Dobrymi serwisami zawierającymi informacje, poradniki oraz artykuły o ciekawych programach są WebUpd8 oraz OMG! Ubuntu!.
Bash wywodzi się z czasów, kiedy interfejsy graficzne jeszcze nie istniały, a potem przez długi czas nie były zbyt powszechne. W tamtym okresie do wykonywania akcji takich jak obliczenia na podstawie danych z otrzymanego dokumentu i tworzenie grafów oraz innych form przetwarzania wymagało łączenia ze sobą wielu małych programów (takich jak AWK/SED – przetwarzanie dokumentu czy bc – wykonywanie obliczeń). Tworząc taki zbiór komend połączonych ze sobą znakami | (przekaż wyjście do następnej komendy) lub && (po zakończeniu wykonaj następującą komendę) za pomocą jednej linijki jesteśmy w stanie na przykład pobrać wszystkie wystąpienia danego słowa w plikach i policzyć je wykonując następnie na podstawie tej informacji wprowadzenie nowego rekordu do bazy danych. Takie linijki nazywamy one-linerami.
Stopniowo łączone ze sobą programy stawały się co raz bardziej skomplikowane i dalsze trzymanie ich w jednej linijce nie miało sensu. Powodowało, że były one kompletnie nieczytelne i niemożliwe do dalszego rozwijania, nie mówiąc już o ponownym wprowadzaniu. Zaczęto zapisywać je w skryptach (plikach tekstowych z rozszerzeniem *.sh zawierających listę instrukcji do wykonania). Bash jest jednym ze środowisk, w których możemy wykonywać nasze komendy. Dostarcza do tego celu mechanizmy pętli oraz instrukcji warunkowych, które ułatwiają tworzenie programów (puryści lubią trzymać się nazywania ich skryptami) wykonujących za nas skomplikowane zadania bez potrzeby naszego czuwania nad ich wykonaniem i podejmowania kolejnych decyzji. Jest to zatem świetne narzędzie do automatyzacji zadań wykonywanych w systemach z rodziny Uniksa (od niedawna również MS Windows). Warto jednak pamiętać, że bash to jedynie środowisko i zestaw podstawowych funkcji. Zaawansowane zadania możemy realizować dzięki zestawom aplikacji dostarczanych w pakietach takich jak coreutils. To dzięki nim w systemie pojawiają się aplikacje awk/sed/cron (planowanie automatycznego wykonania zadania)/bc i wiele innych. Tworzone przez nas linijki czy skrypty są w rzeczywistości kompilowaniem ich funkcji ze sobą, tak byśmy nie musieli żmudnych zadań wykonywać samodzielnie.
Do nauki basha i pozostałych narzędzi linii komend polecam: nixCraft (publikują świetne poradniki), Serię „Bash by example” od IBM, „SED i AWK” na stronie Grzegorza Nalepy, kiedyś O’Reilly wydało świetną książkę „sed & awk”, która została nawet wydana u nas przez Helion, ale niestety ciężko jest nasze rodzime wydanie gdziekolwiek jeszcze dostać. Tu podobnie jak w przypadku systemu Ubuntu, dobrze jest uczyć się kombinując i starając się zrozumieć rozwiązania przedstawiane online dla problemów, które mamy do rozwiązania.
Grafika Ubuntu dzięki uprzejmości Canonical Ltd. udostępniona na licencji CC BY-SA 3.0.
Migracja z CentOS na Scientific Linux
(tl;dr – przejdź do nagłówka „Procedura”)
Rozwiązanie jakim jest zmiana dystrybucji zastosowałem dla określonego w tytule przypadku, jednak z powodzeniem można zastosować je zarówno przy przesiadce z Red Hat Enterprise Linux (RHEL) na dowolną opartą na (i kompatybilną binarnie z) nim dystrybucję, jak i między nimi. Cały proces zawiera się w kilku prostych komendach. Kiedy to może się przydać?
Nowy (sensowny) plan wydawniczy Fedory?
Ubuntu chce iść w rolling release i zaczyna o tym głośno mówić, a tym czasem w Fedorze dyskutują nad bardzo fajnym planem wydawniczym:
Duży numerek co dwa lata, a w międzyczasie XX.0, XX.1, XX.2 i XX.3 co pół roku. W ten sposób nie będą więcej musieli spieszyć się z rzeczami niemożliwymi do właściwego wykonania w obecnym systemie, jak przepisanie anacondy w 6 miesięcy… Każde z tych mniejszych wydań będzie wspierane przez 13 miesięcy – brzmi dobrze i mam nadzieję, że przejdzie!
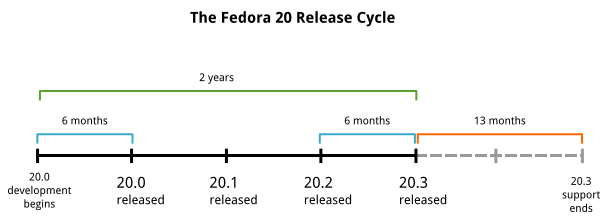
Więcej na ten temat możecie przeczytać na blogu Máirín Duffy, wpis ten zawiera ładne grafiki obrazujące proponowany plan wydawniczy wraz z wyczerpującym opisem. Jest również dostępne nagranie z prezentacji FUDcon, podczas której Spot przedstawiał swoją propozycję:

RMS: Ubuntu to spyware!
Richard Stallman (RMS) – założyciel ruchu wolnego oprogramowania, słynący obecnie z kontrowersyjnych wypowiedzi – powraca na czołówki portali poświęconych WiOO nazywając Ubuntu „spyware”.

Firefox bezsprzecznym zwycięzcą
Po raz kolejny zirytowałem się korzystając z Opery. Tym razem jednak postanowiłem podzielić się swoim powodem, dla którego to Firefox jest bezsprzecznym zwycięzcą mojego prywatnego rankingu przeglądarek i nic nie zapowiada by miało się to zmienić.
Lubię Operę, do Chrome/Chromium mam stosunek raczej obojętny, ale niestety bardzo często pojawia się u mnie moment, w którym obie te przeglądarki nie nadają się do użytku. Nie chodzi tu w żadnym wypadku o głośno omawiane we wszelkich branżowych porównaniach: zarządzanie pamięcią, wykorzystywanie zasobów procesora – jesteśmy w końcówce 2012 roku – dla przeciętnego laptopa te czynniki nie mają wielkiego znaczenia. Kiedyś dość liczącym się argumentem były dodatki – już nie są. Zarówno Opera jak i Chrome dorobiły się bardzo bogatej bazy, która w większości przypadków jest wystarczająca.
id Software otwiera źródła gry Doom 3 BFG
Po ostatnim otwarciu źródeł Dooma 3 rok temu, studio id Software postanowiło otworzyć kod jej ponownego wydania BFG, które pojawiło się na rynku w październiku bieżącego roku.


